Bei der Schätzung von Machine Learning Modellen tritt häufig das Problem der Klassen-Imbalance auf. Das bedeutet, dass die Zielvariable (Target) nicht gleich, sondern ungleichmäßig verteilt ist. Meist ist die positive Klasse sehr klein, während die negative Klasse sehr groß ist, angenommen eine binäre Target-Klasse.
Worin besteht nun das Problem?
Nehmen wir an die Verteilung der binären Zielvariable sieht folgendermaßen aus:
- 95% negative Klasse
- 5% positive Klasse
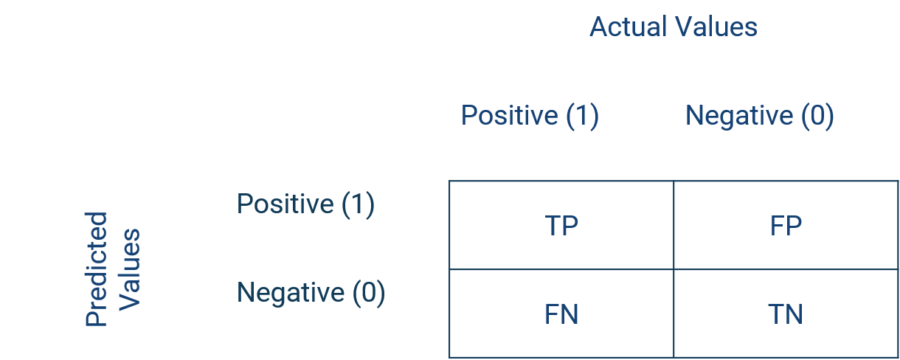
Um den Abstraktionsgrad zu verringern, erläutern wir das Imbalance-Problem mit einem Beispiel. Nehmen wir an, wir möchten den Kauf eines Produktes schätzen: 95% der Kunden in meinem Datensatz haben nicht gekauft, währen nur 5% gekauft haben. Die positive Klasse (Label = 1) lautet demnach „Kauf“ und die negative Klasse (Label = 0) entspricht „Kein Kauf“. Wir schätzen ein Modell, zum Beispiel einen Random Forest. Die folgende fiktive Konfusionsmatrix dient der Illustration:
Somit ergeben sich folgende Performance-Metriken:
- Genauigkeit = (TP + TN) / (TP + TN + FP + FN) = (682 + 24) / 760 = 92,9%
- Sensitivität = TP / (TP + FN) = 24 / (24 + 14) = 63,2%
- Spezifität = TN / (TN + FP) = 682 / (682 + 40) = 94,5%
- Präzision = TP / (TP +FP) = 24 / (24+ 40) = 37,5%
Was sagt mir die Konfusionmatrix?
Die fiktive Konfusionsmatrix bildet häufige Muster in der Realität in nicht-balancierten Datensätzen ab. Betrachten wir nun die Genauigkeit, so sagt unser Modell in ca. 93% der Fälle die Zielvariable korrekt hervor. Absolut klingt dies nach einem sehr guten Modell. Betrachten wir jedoch, dass die negative Klasse (Kein Kauf) in 95% der Fälle (722 / 760) vorliegt und wir somit, sobald wir immer die negative Klasse schätzen würden, schon in 95% der Fälle korrekt vorhersagen würden. Damit relativiert sich die Vorhersagekraft unseres Modells deutlich. Natürlich würde in diesem Fall die Spezifität auf 100% steigen und die Sensitivität auf 0% fallen.
Wie unbalancierte Daten die Modelle beeinflussen
Auch tendieren solche Modelle dazu, existierende Beobachtungen der positiven (kleinen) Klasse (Kauf) als Rauschen einzustufen und neue Beobachtungen eher der negativen (großen) Klasse (kein Kauf) zuzuordnen. Unser Modell überschätzt somit die negative Klasse (Kein Kauf). Jedoch soll unser Modell dazu dienen, die positive Klasse „Kauf“ möglichst korrekt vorherzusagen.
In unserem Beispiel wäre es von Nachteil potenzielle Käufer nicht anzuschreiben, weil sie als Nicht-Käufer eingeordnet werden. Wir nehmen hier an, die Kosten von False Negatives sind größer als die Kosten von False Positives.
Es gibt drei beliebte Methoden, um die Klassen-Imbalance in der Zielvariable zu reduzieren oder zu eliminieren.
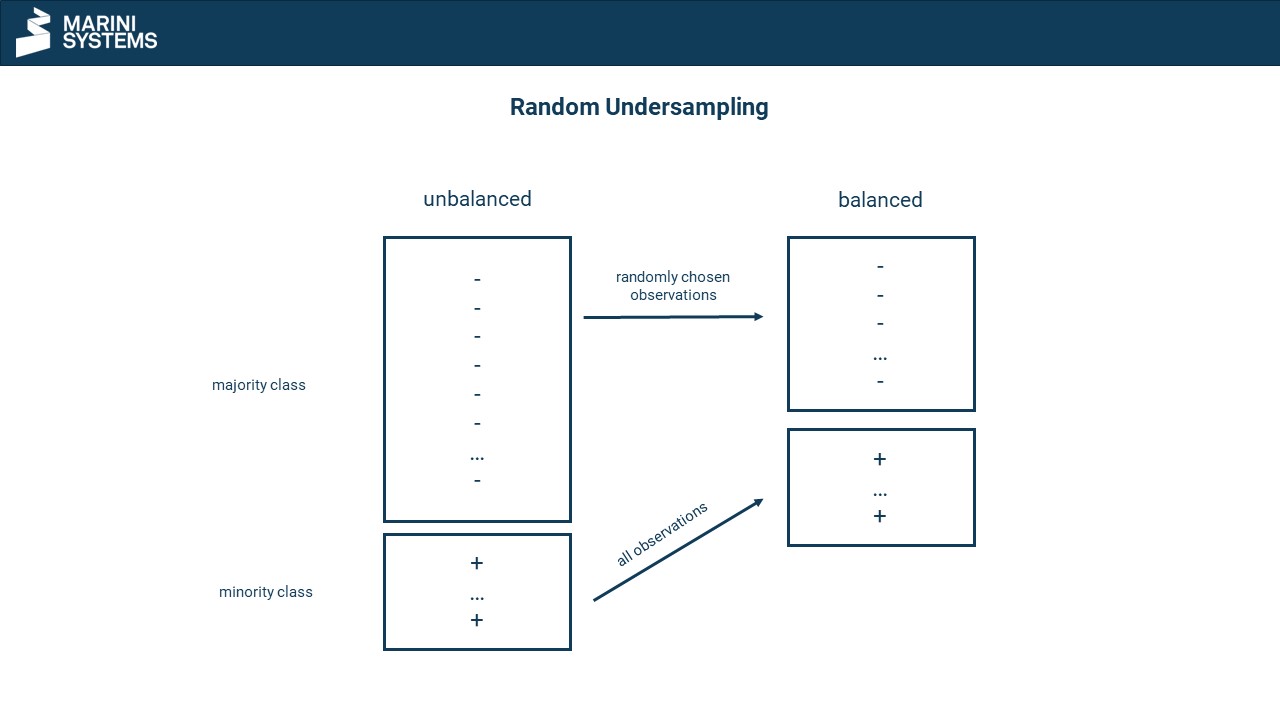
Beim Undersampling werden Beobachtungen aus der großen Klasse zufällig aus dem Datensatz eliminiert. Dadurch erhält man einen balancierteren oder balancierten Datensatz, je nach Anzahl der eliminierten Beobachtungen. Es existieren auch Verfahren, welche nicht zufällig Beobachtungen der großen Klasse selektieren (condensed nearest neighbours). Dabei werden bevorzugt Beobachtungen eliminiert, die anderen sehr ähnlich sind. Das hat den Vorteil, dass keine Beobachtungen mit hohem Informationsgehalt eliminiert werden.
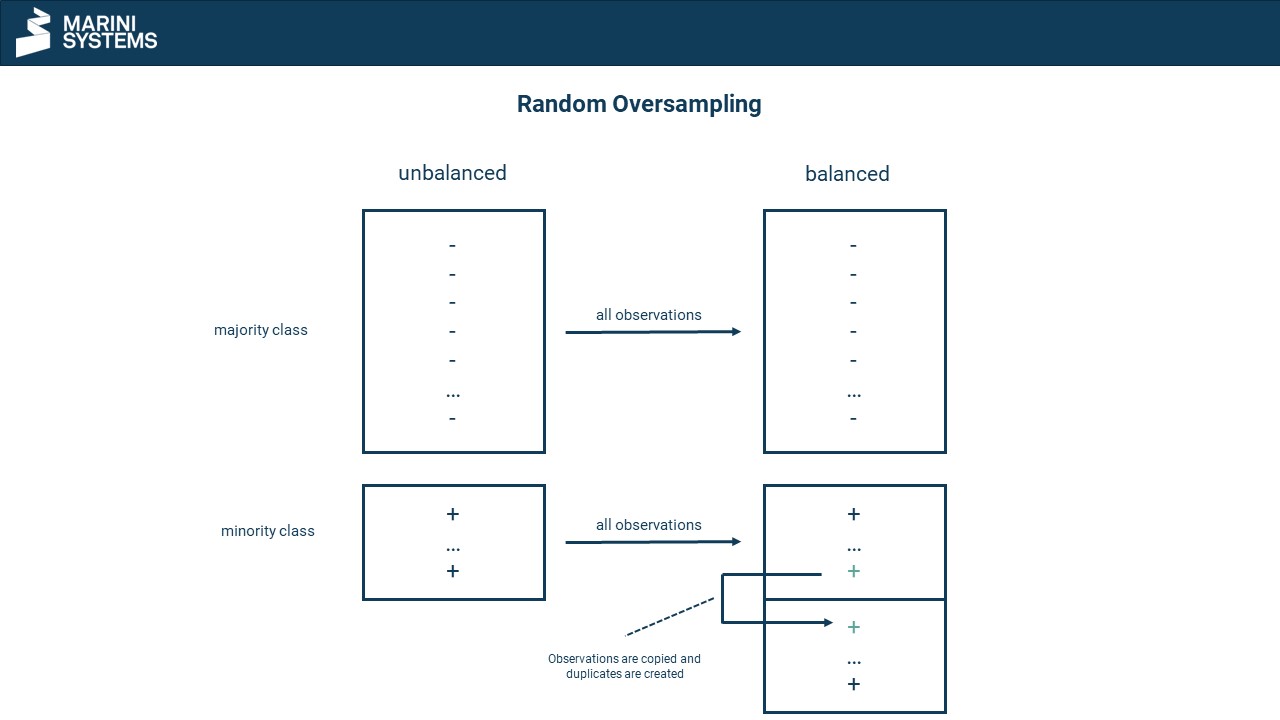
Beim Oversampling wird die kleine Klasse hingegen künstlich vergrößert (siehe Bild). Dies geschieht durch die zufällige Duplizierung bzw. Vervielfältigung von Beobachtungen aus der kleinen Klasse bis zur gewünschten Balance-Ratio. Eine Gefahr besteht hier jedoch, dass Modelle danach tendenziell ins Overfitting rutschen.
Ebenso ist eine Kombination aus Undersampling und Oversampling möglich.
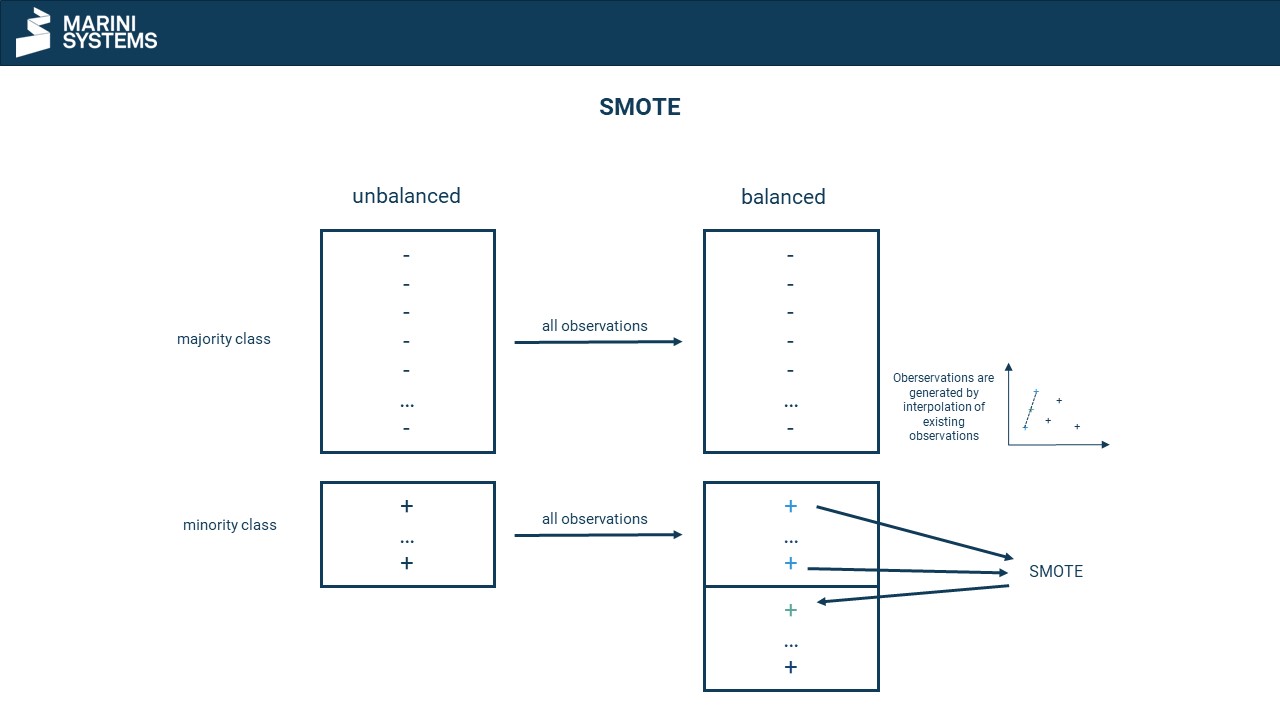
SMOTE steht für Synthetic Minority Oversampling Technique. SMOTE ist eine Methode des Oversamplings. Dabei wird die kleine Klasse künstlich vergrößert, jedoch diesmal nicht zufällig. Ein Datenpunkt im multivariaten Raum wird mit seinen k neighbours betrachtet. Nun wird ein Vektor zu einem von den Nachbarpunkten genommen und dieser Vektor mit einer zufälligen Zahl zwischen 0 und 1 multipliziert. Die Multiplikation wird als neuer Datenpunkt hinzugefügt und unterscheidet sich nun von dem ursprünglichen Datenpunkt. Es werden somit keine Kopien gebildet, sondern neue abgeänderte Datenpunkte synthetisiert.
Du suchst nach hands-on Tutorials in Python, um deine Klassen zu balancieren? Wir empfehlen das Modul imbalance-learn!
Auf Kaggle findest du ein sehr ausschöpfendes Tutorial zu unbalancierten Daten.